Fehler suchen statt neu bauen
Erst Ursache finden. Dann so wenig ändern wie nötig – und so viel wie wirklich sinnvoll.
Wenn eine Webseite, ein Server oder eine Anwendung plötzlich nicht mehr richtig funktioniert, ist ein kompletter Neubau selten die erste technische Frage. Zuerst sollte geklärt werden, was genau fehlschlägt, unter welchen Bedingungen und seit welcher Änderung. Diese Seite bündelt eine ruhige Werkstattmethode für Webfehler – von HTML und CSS über JavaScript, HTTP, DNS und TLS bis zu CMS, Frameworks, Logs, Backups und Versionskontrolle.
Sie ist bewusst eher Haltung als Rezeptbuch: Nicht jeder Altbestand ist erhaltenswert, nicht jeder Rewrite ist falsch und nicht jeder Patch ist klug. Entscheidend ist, dass ein Austausch eine begründete Entscheidung bleibt – nicht die reflexartige Antwort auf ein noch unverstandenes Symptom.
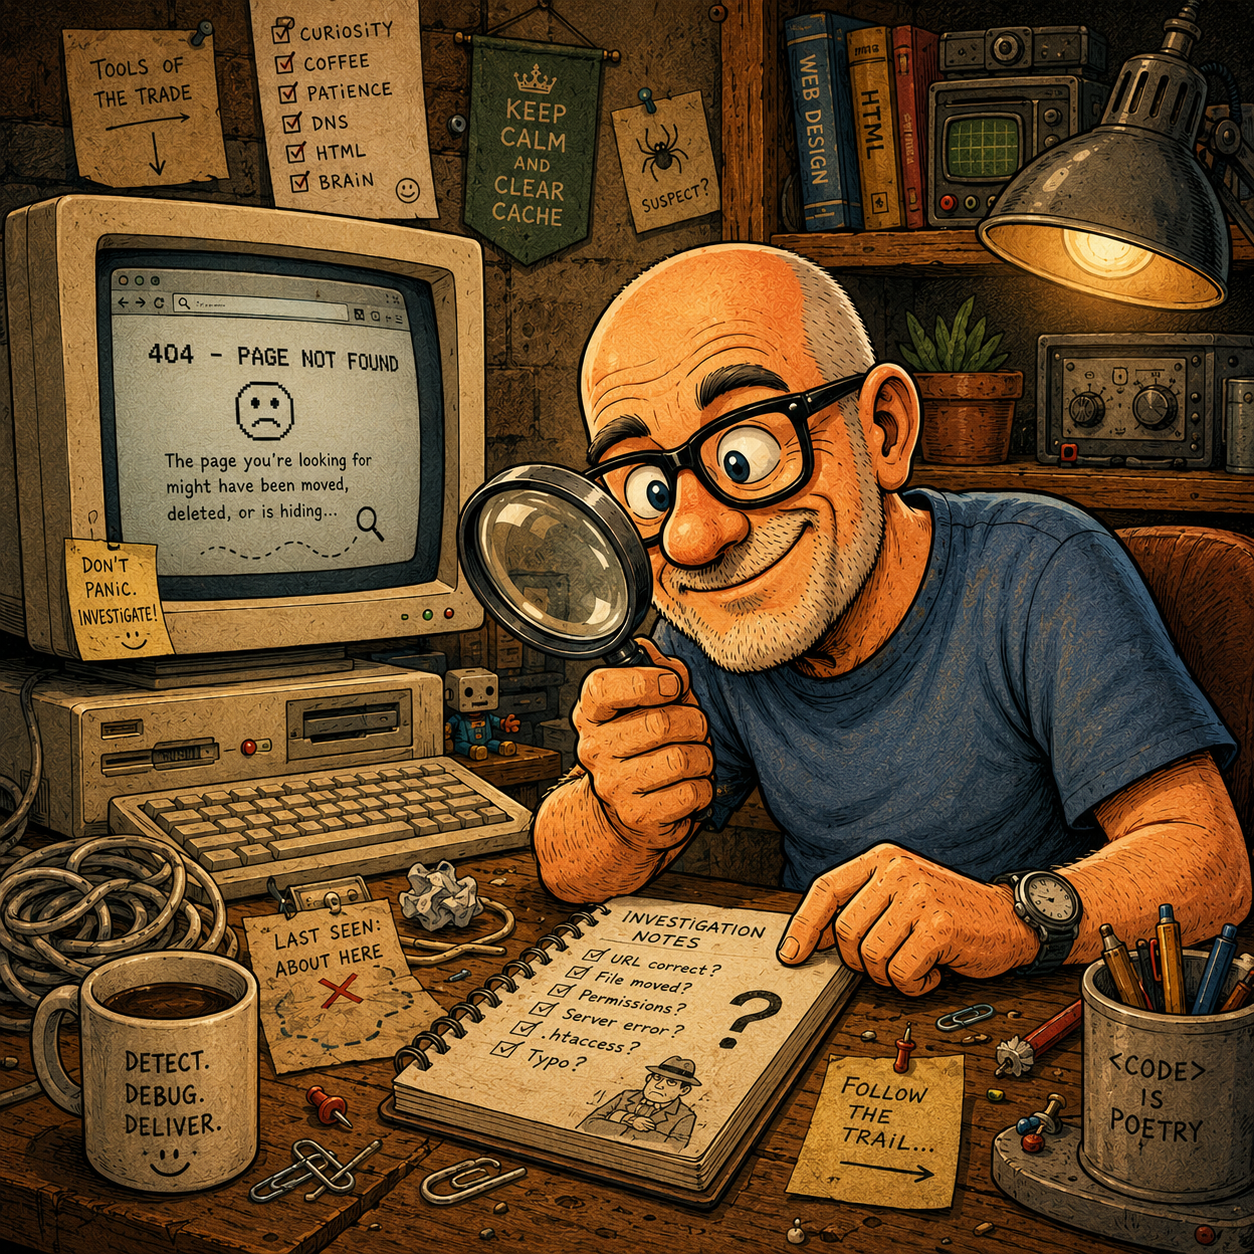
Die neue Werkstattfigur passt hier ziemlich genau: erst nachsehen, was tatsächlich kaputt ist. Ein 404 muss nicht durch ein neues CMS geheilt werden, ein CSS-Fehler braucht nicht automatisch ein Redesign und ein falscher Header selten ein neues Framework.
Debug Diagnostic
Fehlersuche ist zuerst eine Haltung
Ein Fehler ist kein überzeugendes Argument dafür, das betroffene System sofort zu ersetzen. Er ist zunächst eine Information: Etwas verhält sich anders als erwartet. Die technische Aufgabe besteht darin, die Abweichung zu beschreiben, zu reproduzieren, einzugrenzen und ihre Ursache so weit zu verstehen, dass eine gezielte Änderung möglich wird.
Diese Haltung wirkt unspektakulär, ist aber langfristig entscheidend. Wer bei jedem Problem sofort Theme, CMS, Framework, Hosting, JavaScript-Bibliothek oder komplette Gestaltung austauscht, verändert gleichzeitig zu viele Variablen. Das ursprüngliche Problem kann verschwinden – aber ebenso gut nur verdeckt werden, während neue Fehler, neue Abhängigkeiten und neue Unklarheiten entstehen.
„Fehler suchen statt neu bauen“ bedeutet deshalb nicht, alte Technik um jeden Preis zu konservieren. Es bedeutet: erst Diagnose, dann Entscheidung. Reparatur, Refactoring, Migration und Neubau sind unterschiedliche Werkzeuge. Das richtige Werkzeug lässt sich erst wählen, wenn das Problem ausreichend verstanden ist.
Symptom und Ursache sind selten dasselbe
Eine weiße Seite ist ein Symptom. Die Ursache kann ein JavaScript-Fehler, eine nicht geladene Ressource, eine Content-Security-Policy, ein Serverfehler, ein kaputtes Template, eine fehlerhafte Datenbankabfrage oder schlicht ein falscher Dateipfad sein. Ein verschobenes Layout ist ein Symptom. Die Ursache kann eine einzelne CSS-Regel, ein fehlendes Bildmaß, eine veränderte Schriftmetrik, ein ungültiges DOM oder ein Browserunterschied sein.
Systematische Fehlersuche trennt daher Beobachtung von Erklärung. Der erste Satz lautet nicht „CSS ist kaputt“, sondern beispielsweise: „Ab 768 Pixel Breite rutscht die Navigation nach der letzten Änderung in zwei Zeilen und überdeckt den Inhalt.“ Diese Formulierung ist prüfbar. „CSS ist kaputt“ ist es nicht.
| Ebene | Beobachtung | Mögliche Ursachen |
|---|---|---|
| Darstellung | Button liegt außerhalb des Viewports | CSS, Containerbreite, transform, fixed positioning, Zoom, Safe Area |
| Funktion | Formular sendet nicht | Client-Validierung, JS, Netzwerk, Serverroute, CSRF, Backend, Mailtransport |
| Erreichbarkeit | Seite lädt nicht | DNS, TLS, HTTP, Rewrite, Dateirechte, Anwendung, Upstream |
| Performance | Seite ist langsam | TTFB, Bilder, Fonts, JS, Drittanbieter, Datenbank, Cache, CPU/IO |
| Indexierung | Seite erscheint nicht in Suche | robots, noindex, Canonical, Statuscode, interne Links, Inhalt, Crawling |
Reparieren, refaktorieren oder ersetzen sind drei verschiedene Entscheidungen
Reparatur stellt das erwartete Verhalten mit möglichst kleinem Eingriff wieder her. Refactoring verändert die innere Struktur, ohne die beabsichtigte Funktion unnötig zu ändern. Neubau oder Migration ersetzt wesentliche Teile des Systems. Diese drei Ebenen werden in hektischer Fehlersuche gerne vermischt.
| Frage | Reparatur | Refactoring | Neubau/Migration |
|---|---|---|---|
| Ziel | Konkreten Defekt beseitigen | Struktur beherrschbarer machen | Grundlage ersetzen |
| Änderungsumfang | klein | mittel, schrittweise | groß |
| Risiko | meist lokal | kontrollierbar bei Tests | hoher Integrations- und Migrationsaufwand |
| Beweislast | Ursache klar genug | Wiederkehrende Strukturprobleme | Alte Basis verhindert nachweisbar sichere/tragfähige Weiterentwicklung |
| Rollback | einfach | sollte möglich sein | muss geplant und getestet sein |
Der häufigste Denkfehler lautet: „Weil die Reparatur mühsam ist, ist ein Neubau automatisch einfacher.“ Das kann stimmen – muss aber nicht. Ein Neubau verschiebt die Arbeit oft nur von der Fehlersuche in Migration, Datenübernahme, Kompatibilität, Redirects, Tests, Schulung und neue Fehlerbilder.
Bevor etwas geändert wird: den Fehler reproduzieren
Ein Fehler, der nicht reproduzierbar beschrieben ist, lässt sich nur schwer zuverlässig beseitigen. Vor der ersten Änderung sollte deshalb ein kleiner Testablauf feststehen: Welche URL? Welcher Browser? Welche Bildschirmbreite? Eingeloggt oder nicht? Welche Aktion? Welche erwartete Ausgabe? Welche tatsächliche Ausgabe?
- URL und Zeitpunkt notieren.
- Browser, Betriebssystem und relevante Versionen erfassen.
- Bei responsiven Problemen die Viewportgröße notieren.
- Netzwerkbedingungen, Loginzustand und Cookies nur dann einbeziehen, wenn sie relevant sind.
- Screenshot, Konsolenfehler, HTTP-Status und gegebenenfalls Logzeitpunkt sichern.
- Prüfen, ob der Fehler bei einem zweiten Gerät oder Browser ebenfalls auftritt.
Das Ziel ist kein bürokratischer Bericht, sondern ein wiederholbarer Versuch. Wenn derselbe Ablauf den Defekt zuverlässig hervorruft, wird jede spätere Änderung messbar.
Den Ausgangszustand sichern – sonst verändert man Beweise
Vor einer Reparatur sollte der aktuelle Zustand gesichert sein: Quellcode, Konfiguration, Datenbankstand soweit erforderlich, wichtige Header, Screenshots und gegebenenfalls Serverlogs. Wer direkt im Produktivsystem mehrere Dateien gleichzeitig verändert, vernichtet im schlimmsten Fall genau die Informationen, die zur Ursache geführt hätten.
Bei statischen Webseiten ist eine Kopie des aktuellen Webroots oft trivial und sehr wertvoll. Bei CMS oder Anwendungen gehören Datenbank und Upload-Verzeichnis dazu. Bei serverseitigen Problemen sind aktive Rewrite-, Proxy-, TLS- und PHP-/Runtime-Einstellungen Teil des Zustands. Ein Backup ist dabei nicht nur Katastrophenschutz, sondern Diagnosewerkzeug und Rückfalloption.
Eine gute Fehlerbeschreibung ist enger als eine Vermutung
Nützlich ist die Form: Unter Bedingung X passiert Y, erwartet wird Z. Dazu kommt: Seit wann? Immer oder nur manchmal? Alle Nutzer oder nur einzelne? Eine URL oder die ganze Site? Nur mobil? Nur nach Login? Nur nach Cache-Leerung?
> URL: /beispiel.htm
> condition: viewport <= 760px
> expected: navigation remains above content
> actual: second nav row overlaps headline
> first_seen: after CSS change 14:32
> scope: reproducible in Chrome + Firefox, not content-specific
So entsteht aus „mobil ist kaputt“ ein untersuchbares Problem.
Den Umfang bestimmen: lokal, systemweit oder nur scheinbar systemweit?
Die schnellste Eingrenzung beginnt mit der Frage nach dem Scope. Funktioniert eine andere Seite mit derselben Vorlage? Funktioniert dieselbe Seite ohne bestimmte Komponente? Sind nur neue Inhalte betroffen? Sind statische Dateien erreichbar, während dynamische Seiten ausfallen?
- Eine einzelne URL: Inhalt, Templateparameter, Dateiname, spezifische Ressource.
- Eine Seitengruppe: gemeinsames Template, Verzeichnis, Route, Datenquelle.
- Gesamte Domain: DNS, TLS, Server, zentrale Konfiguration, Deployment.
- Nur ein Browser: CSS-/JS-Kompatibilität, Cache, Erweiterungen, Browserbug.
- Nur einzelne Nutzer: Session, Rolle, Datenzustand, lokaler Cache, Netzwerk.
Je kleiner der tatsächlich betroffene Bereich, desto weniger sinnvoll ist ein großflächiger Austausch.
Die Zeitachse: Wann war es zuletzt sicher gut?
Bei Regressionen ist die wichtigste historische Information oft der letzte bekannte gute Zustand. Wenn eine Seite gestern funktionierte und heute nicht, liegt die Ursache wahrscheinlich in einer überschaubaren Menge von Änderungen: Deployment, Konfiguration, Zertifikat, DNS, Daten, Pluginupdate, Browserupdate oder externer Dienst.
Die Frage „Was wurde seitdem verändert?“ ist wesentlich ergiebiger als „Was könnte theoretisch alles kaputt sein?“. Gute Änderungsprotokolle, Versionskontrolle und datierte Backups reduzieren den Suchraum dramatisch.
Eine Variable nach der anderen
Das klassische Gegenstück zur Fehlersuche ist das gleichzeitige Ändern von fünf Dingen: Cache löschen, Plugin deaktivieren, CSS neu schreiben, Server umstellen und Framework aktualisieren. Wenn der Fehler danach verschwunden ist, weiß niemand warum.
Besser ist kontrolliertes Variieren. Eine Änderung, ein Test, ein Ergebnis. Muss aus praktischen Gründen ein Bündel geändert werden, sollte zumindest klar dokumentiert sein, welche Einzeländerungen darin stecken. Die Methode ist langsamer pro Schritt, aber schneller bis zu einer belastbaren Erklärung.
Den kleinsten fehlerhaften Fall herstellen
Komplexität verdeckt Ursachen. Ein Minimalfall entfernt alles, was für das Fehlverhalten nicht nötig ist. Bei CSS kann das ein kleines HTML-Dokument mit nur dem betroffenen Container sein. Bei JavaScript eine Funktion mit wenigen Eingabedaten. Bei einem Rewrite eine einzelne Test-URL. Bei einem CMS eine Seite ohne optionale Plugins.
Der Minimalfall beantwortet zwei Fragen: Welche Teile sind wirklich notwendig, damit der Fehler auftritt? Und: Welcher entfernte Teil lässt ihn verschwinden? Genau dort liegt oft die interessante Grenze.
Browser-Entwicklertools: erst beobachten, dann editieren
Moderne Browser liefern bereits einen großen Teil der Werkstatt: DOM-Inspektor, berechnete CSS-Regeln, Console, Netzwerkprotokoll, Storage, Performance-Aufzeichnung und Emulation. Chrome beschreibt DevTools ausdrücklich als Werkzeuge zum Diagnostizieren und schnellen Untersuchen von Webseiten; ähnliche Werkzeuge existieren in Firefox und anderen Browsern.
- Im Elements/Inspector prüfen, welche Regel tatsächlich gewinnt.
- In der Console Fehler und Warnungen zeitlich mit dem Problem abgleichen.
- Im Network-Panel Statuscodes, Redirects, fehlende Dateien, Caching und Ladezeiten prüfen.
- Im Application/Storage-Bereich Cookies, Local Storage, Cache und Service Worker kontrollieren.
- Änderungen im Inspector zunächst als Experiment behandeln – nicht als bereits bewiesene Dauerlösung.
Der entscheidende Unterschied: DevTools ermöglichen Hypothesentests, ohne sofort Produktionsdateien umzuschreiben.
HTML prüfen: Strukturfehler können wie CSS- oder JavaScript-Probleme aussehen
Ungültig verschachtelte Elemente, doppelte IDs, fehlende schließende Tags oder unerwartete DOM-Korrekturen des Browsers können Folgefehler erzeugen. Deshalb lohnt bei merkwürdigen Layout- oder Selektorproblemen ein Blick auf das tatsächlich erzeugte DOM, nicht nur auf die Quelldatei.
Validatoren und HTML-Checker sind keine magische Qualitätsprüfung, aber sie helfen, strukturelle Fehler und unbeabsichtigte Abweichungen zu finden. Besonders bei alten, über Jahre erweiterten Seiten ist das oft schneller als kosmetische CSS-Gegenmaßnahmen.
CSS: Kaskade, Spezifität und Geometrie statt blindes Überschreiben
Viele CSS-Reparaturen scheitern daran, dass eine neue Regel lediglich eine alte Regel überstimmt. Danach folgt die nächste Ausnahme, dann !important, dann ein weiterer Media Query. Der sichtbare Fehler verschwindet, aber die Ursache bleibt in der Kaskade erhalten.
- Berechnete Werte statt nur Stylesheettext ansehen.
- Prüfen, aus welcher Regel ein Wert stammt und warum sie gewinnt.
- Box-Modell, min/max-width, overflow, flex/grid und positionierte Elemente getrennt untersuchen.
- Media Queries nach tatsächlich aktiven Bedingungen prüfen.
- Bei Layoutregressionen den kleinsten CSS-Unterschied zum letzten guten Stand suchen.
Eine gute CSS-Reparatur reduziert Widersprüche. Eine schlechte fügt nur eine stärkere Ausnahme hinzu.
JavaScript: den ersten relevanten Fehler finden
Ein später Konsolenfehler ist oft nur Folge eines früheren Problems. Deshalb zählt die Reihenfolge. Fehlende Module, falsche Selektoren, unerwartete null-Werte, blockierte Requests oder CSP-Verstöße können eine ganze Kette weiterer Meldungen erzeugen.
Hilfreich sind Breakpoints, gezielte Logs, reproduzierbare Eingaben und das schrittweise Deaktivieren unabhängiger Funktionen. Große Minified-Bundles erschweren die Arbeit; Source Maps und klare Modulgrenzen verbessern die Diagnose. Auch hier gilt: Frameworkwechsel ist keine Ersatzhandlung für das Verstehen eines konkreten Fehlers.
Netzwerk und HTTP: Status, Header und Redirects sind Teil der Diagnose
Eine Webseite ist nicht nur HTML. Zwischen Adresse und Darstellung liegen DNS, TLS, HTTP, Redirects, Caches, Proxies und Serveranwendung. RFC 9110 beschreibt die Semantik von HTTP – also unter anderem, wie Requests, Responses, Statuscodes und Ressourcenbezeichner verstanden werden.
> curl -I https://example.org/page.htm
> inspect: status / Location / Content-Type / Cache-Control / CSP
> follow redirects only after first hop is understood
> browser message is evidence; raw response is closer to the wire
Ein Browser kann eine hübsche Fehlerseite anzeigen, obwohl der Server 200 liefert. Ein Redirect kann in der Oberfläche unsichtbar wirken. Deshalb lohnt bei Erreichbarkeitsproblemen die Prüfung der tatsächlichen HTTP-Kette.
Caches: Fehler können behoben sein und trotzdem weiterleben – oder umgekehrt
Browsercache, Reverse Proxy, CDN, Service Worker und serverseitige Caches können unterschiedliche Stände ausliefern. „Nach Strg+F5 geht es“ ist daher eine wichtige Beobachtung, aber noch keine Ursache.
- Cacheebenen identifizieren statt pauschal „Cache löschen“.
- Header wie Cache-Control, ETag und Last-Modified prüfen, sofern relevant.
- Service Worker gesondert betrachten; sie können Requests abfangen.
- CDN- oder Proxy-Purges dokumentieren, weil sie den Testzustand verändern.
- Nach einer Reparatur auch einen normalen kalten und warmen Aufruf testen.
DNS und TLS: vor dem HTML kann bereits alles entschieden sein
Wenn eine Domain auf die falsche Adresse zeigt, ein Zertifikat nicht zum Host passt oder IPv4 und IPv6 unterschiedliche Ziele erreichen, hilft kein Redesign. Deshalb müssen Erreichbarkeitsprobleme schichtweise von außen nach innen untersucht werden.
Wichtig sind dabei insbesondere A/AAAA/CNAME, Nameserverzuständigkeit, Zertifikatsname und -kette, SNI/virtueller Host sowie die Frage, ob www und nackte Domain dieselbe beabsichtigte Konfiguration erreichen. Änderungen an DNS und TLS haben eigene Laufzeiten und Cacheeffekte; sie sollten nicht mit gleichzeitigem CMS-Umbau vermischt werden.
Webserver und Rewrite-Regeln: kleine Zeichen, große Wirkung
Eine einzige falsche Rewrite-Regel kann Schleifen, falsche Ziele, verlorene Query-Strings oder unerreichbare Dateien erzeugen. Deshalb sollten Regeln in einer klaren Reihenfolge stehen und mit konkreten Test-URLs geprüft werden. Besonders gefährlich ist es, während der Fehlersuche alte und neue Redirectsysteme gleichzeitig aktiv zu lassen – etwa Provider-Weiterleitung plus .htaccess plus Anwendung.
Bei Fehlerseiten gilt zusätzlich: Das HTML der Fehlerseite und der HTTP-Status sind zwei verschiedene Dinge. Eine hübsche 404-Datei, die mit Status 200 ausgeliefert wird, ist technisch weiterhin keine korrekte 404-Antwort.
CMS: Plugin, Theme, Core und Inhalt getrennt betrachten
Bei CMS-Problemen ist „WordPress/Joomla/Drupal ist kaputt“ meist zu grob. Die relevante Ebene kann Core, Plugin, Theme, PHP-/Runtime-Version, Datenbank, Cache, Rechte oder Hosting sein. Sinnvoll ist eine kontrollierte Konfliktanalyse: letzter guter Stand, Updatezeitpunkt, einzelne Erweiterungen, Fehlerlog und Stagingkopie.
Ein kompletter CMS-Wechsel ist dann gerechtfertigt, wenn die Plattform dauerhaft ungeeignet oder nicht mehr sicher betreibbar ist – nicht bloß weil ein einzelnes Plugin einen Fehler verursacht. Eine Migration erzeugt neue Themen: URL-Mapping, Datenexport, Medien, Rechte, Templates, Suchfunktionen, Redirects, Performance und Langzeitpflege.
Frameworks: Abstraktion kann helfen – und Ursachen verdecken
Frameworks lösen reale Probleme: Routing, Komponenten, State, Build-Prozesse, Testing und Wiederverwendung. Gleichzeitig fügen sie Schichten hinzu. Ein Fehler kann im eigenen Code, in einer Bibliothek, im Build, im Bundler, in Transpilation, Hydration, Server-Side Rendering oder einer Versionsinkompatibilität liegen.
Darum ist „wir wechseln das Framework“ eine besonders teure Form der Fehlersuche. Sie kann als strategische Migration sinnvoll sein, aber nicht als reflexartige Reparatur. Erst wenn klar ist, dass die vorhandene Basis strukturell blockiert, endet Fehlersuche sinnvollerweise in einer Migrationsentscheidung.
Daten und Datenbank: Der Code kann korrekt sein und die Daten trotzdem nicht
Fehler treten oft nur bei bestimmten Datensätzen auf: unerwartetes null, Zeichencodierung, zu lange Werte, inkonsistente Beziehungen, veraltete Migrationen oder ein spezieller Benutzerzustand. Wer nur Quellcode betrachtet, übersieht diese Klasse von Problemen.
Ein reproduzierbarer Testdatensatz ist deshalb wertvoll. Produktivdaten sollten dabei datenschutzgerecht behandelt und für Tests nach Möglichkeit minimiert oder anonymisiert werden. Vor Schemaänderungen braucht es ein Backup und einen Rückweg.
Drittdienste: Wenn die eigene Seite von fremden Systemen abhängt
APIs, Fonts, Karten, Zahlungsdienste, Captchas, Analyse- und Consent-Systeme können eine ansonsten funktionierende Seite beeinflussen. Diagnose bedeutet hier: Welche Anfrage geht an welchen Dienst? Welche Antwort kommt zurück? Welche Timeouts, Rate Limits, CORS- oder Authentifizierungsfehler treten auf?
Je weniger externe Abhängigkeiten eine Seite hat, desto kleiner ist dieser Suchraum. Das ist einer der Gründe, warum sslxy bei vielen Archivseiten bewusst statisch und zurückhaltend bleibt.
Langsam ist kein einzelner Fehler: Performance zerlegen
„Die Seite ist langsam“ kann DNS, TLS, Serverantwort, Datenbank, Render-Blocking, Bilder, JavaScript, Fonts, Drittanbieter oder Gerätelast bedeuten. Die Reparatur beginnt mit Messpunkten, nicht mit einem Redesign.
| Phase | Frage | Typische Werkzeuge |
|---|---|---|
| Verbindung | Dauern DNS/TLS auffällig lange? | Network waterfall, curl, DNS-Tools |
| Server | Ist TTFB hoch? | Serverlogs, APM, Timing |
| Transfer | Sind Assets unnötig groß? | Network, Bild-/Bundleanalyse |
| Rendering | Blockieren CSS/JS oder Layoutarbeit? | Performance profiler |
| Interaktion | Blockiert Main Thread / lange Tasks? | Profiler, Long Tasks, Performance traces |
Erst wenn die Engstelle identifiziert ist, wird optimiert. Sonst ist „Performancearbeit“ oft nur optische Aktivität.
Barrierefreiheitsfehler: Semantik vor kosmetischer Nacharbeit
Wenn Tastaturnavigation, Fokus, Beschriftung oder Screenreader-Ausgabe nicht stimmen, sollte die Ursache möglichst in der semantischen Struktur behoben werden. Ein zusätzlicher JavaScript-Workaround kann eine schlechte HTML-Grundlage noch komplizierter machen.
- Native HTML-Elemente bevorzugen, wo sie die gewünschte Funktion bereits liefern.
- Fokusreihenfolge und sichtbaren Fokus prüfen.
- Labels, Namen und Zustände kontrollieren.
- Kontrast- und Zoomprobleme nicht nur bei einer Standardauflösung testen.
- Automatische Prüfungen als Hinweis, manuelle Bedienung als notwendige Ergänzung verstehen.
SEO-Probleme: Technik, Inhalt und Indexierung auseinanderhalten
Wenn eine Seite nicht gefunden wird, ist ein neues Design selten die erste sinnvolle Maßnahme. Zu prüfen sind Statuscode, Robots-Direktiven, Canonical, interne Links, Sitemap, Rendering und tatsächlicher Inhalt. Ebenso wichtig ist, ob das Problem eine einzelne URL oder die gesamte Domain betrifft.
Die Diagnose sollte außerdem zwischen Crawling, Indexierung und Ranking unterscheiden. Diese Phasen haben unterschiedliche Ursachen. Ein 200-Status garantiert keine Indexierung; eine indexierte Seite garantiert kein bestimmtes Ranking.
Sicherheitsprobleme sind die Grenze für gemütliche Fehlersuche
Bei Verdacht auf Kompromittierung, Datenabfluss oder aktive Ausnutzung gilt eine andere Priorität: eindämmen, Beweise erhalten, Zugangsdaten und betroffene Systeme schützen, dann analysieren. Hier kann eine schnelle Abschaltung oder Isolation wichtiger sein als elegante Ursachenforschung im laufenden Betrieb.
Trotzdem bleibt die Grundlogik gleich: Symptome und Ursache trennen, Logs sichern, Änderungen nachvollziehen und nach der Eindämmung verstehen, wie der Vorfall möglich war. OWASP weist darauf hin, dass Anwendungslogs oft Informationen liefern, die reine Infrastrukturprotokolle nicht enthalten. Gute Logs sind daher nicht nur Sicherheitsfunktion, sondern Diagnosebasis.
Responsive Fehler: nicht „mobil“ gegen „Desktop“ denken
Viele Darstellungsfehler entstehen an Übergängen: bestimmte Breiten, Textlängen, Zoomstufen oder Kombinationen aus Navigation und Inhalt. Zwei feste Testgeräte reichen nicht. Sinnvoller ist, die Breite kontinuierlich zu verändern und den Punkt zu finden, an dem das Layout kippt.
Dann lässt sich fragen: Welche Regel wird genau dort aktiv? Welche Mindestbreite erzwingt ein Element? Gibt es feste Pixelwerte, lange untrennbare Wörter, Bilder ohne flexible Breite oder eine Sticky-/Fixed-Komponente, deren Platz nicht berücksichtigt wird?
Browserunterschiede: erst den Unterschied isolieren, nicht den Browser beschuldigen
Wenn ein Problem nur in einem Browser auftritt, ist das wertvolle Eingrenzung. Trotzdem sollte man nicht sofort von „Browserfehler“ ausgehen. Unterschiede können aus nicht standardisiertem Verhalten, veralteten Präfixen, experimentellen APIs, unterschiedlichen Default-Styles, Timing oder Caching entstehen.
Ein kleiner reproduzierbarer Testfall zeigt, ob tatsächlich eine Browserimplementierung beteiligt ist. Bis dahin bleibt die Hypothese offen. Polyfills und Browserweichen sollten erst eingesetzt werden, wenn klar ist, welche Fähigkeit fehlt oder abweicht.
Logs: die Zeitmaschine der Fehlersuche
Logs sind besonders wertvoll, wenn ein Fehler nicht zuverlässig im eigenen Browser auftritt. Ein sauberer Zeitstempel, Request-ID, Statuscode, Pfad und relevante Anwendungsereignisse können aus „manchmal geht es nicht“ eine konkrete Kette machen.
- Webserver-Access- und Error-Logs getrennt betrachten.
- Anwendungslogs auf korrelierbare IDs und sinnvolle Fehlerkontexte prüfen.
- Keine Passwörter, Session-Geheimnisse oder unnötige personenbezogene Daten protokollieren.
- Zeitzonen und Uhrzeiten zwischen Systemen synchron halten.
- Vor Logrotation oder Neuinstallation relevante Ausschnitte sichern.
Das Ziel ist nicht möglichst viel Logging, sondern genügend Kontext, um einen Fehlerpfad nachträglich zu rekonstruieren.
Versionskontrolle: Unterschiede werden messbar
Versionskontrolle beantwortet die Frage „Was hat sich geändert?“ wesentlich besser als Erinnerung. Ein Diff zeigt konkrete Zeilen, ein Commit bildet eine Zeitmarke, und ein sauberer Verlauf ermöglicht Regressionseingrenzung.
Git stellt mit git bisect sogar eine binäre Suche über die Historie bereit: Ein bekannter guter und ein bekannter schlechter Stand werden angegeben; Git wählt Zwischenstände aus, bis der erste problematische Commit eingegrenzt ist. Das ist ein gutes Beispiel für systematische Fehlersuche: Suchraum halbieren statt überall gleichzeitig zu suchen.
> git bisect start
> git bisect bad
> git bisect good <known-good-commit>
> test selected revisions as good/bad
> result: first change that introduced the property
Backup und Rollback: eine Reparatur braucht einen Rückweg
Ein Rollback ist keine Niederlage. Er ist ein vorgesehenes Kontrollmittel. Wenn eine Änderung unerwartete Nebenwirkungen zeigt, ist die Fähigkeit, den letzten guten Zustand schnell wiederherzustellen, oft wichtiger als hektisches Weiterpatchen.
Dazu muss der Rückweg vor der Änderung bekannt sein: Welche Dateien? Welche Datenbank? Welche Konfiguration? Welche Cacheebenen? Welche Deployment-Version? Ein ungetestetes Backup ist nur eine Hoffnung. Besonders bei größeren Updates sollte die Wiederherstellung praktisch erprobt sein.
Ein kleines Änderungslog spart später Stunden
Bei langjährig gepflegten Seiten genügt oft ein schlichtes Protokoll: Datum, Änderung, Grund, betroffene Dateien, erwartetes Ergebnis, Rückfalloption. Es muss kein komplexes Ticketsystem sein. Entscheidend ist, dass spätere Fehlersuche nicht bei null beginnt.
> 2026-09-04 14:10
> change: mobile nav breakpoint 760 -> 780
> reason: overlap at 768px with long label
> files: style block in template
> rollback: restore previous file snapshot
Schrotflinten-Debugging: viel ändern, wenig lernen
„Schrotflinten-Debugging“ bezeichnet die Praxis, auf Verdacht viele Stellen zu ändern, bis das Problem scheinbar verschwindet. Das kann unter Zeitdruck verführerisch sein, produziert aber kaum Wissen. Häufig bleiben tote Workarounds, widersprüchliche Regeln und neue Seiteneffekte zurück.
- Mehrere Plugins gleichzeitig deaktivieren und später nicht wissen, welches relevant war.
- Große CSS-Blöcke mit
!importantüberdecken. - Caches, DNS, Browserdaten und Serverkonfiguration gleichzeitig ändern.
- Framework- oder Runtime-Versionen überspringen, ohne vorher Ursache oder Kompatibilität zu prüfen.
- Produktionsdateien direkt editieren, ohne Ausgangsstand und Diff.
Eine kurzfristig erfolgreiche Zufallsänderung ist noch keine Diagnose.
KI in der Fehlersuche: Hypothesenmaschine, nicht Wahrheitsquelle
KI kann Fehlersuche beschleunigen: Fehlermeldungen erklären, mögliche Ursachen sortieren, Testfälle formulieren, Diffs lesen oder kleine reproduzierbare Beispiele vorschlagen. Besonders nützlich ist sie, wenn konkrete Evidenz vorliegt: Codeausschnitt, Header, Logzeile, Browsermeldung und erwartetes Verhalten.
Gefährlich wird es, wenn ein Modell fehlenden Kontext mit plausibel klingenden Annahmen füllt. Dann entsteht schnell ein großer Umbauvorschlag für ein kleines Problem. Gute Nutzung bedeutet daher: KI soll Hypothesen erzeugen, Tests vorschlagen und Änderungen erklären – aber die reale Umgebung entscheidet.
- Keine Geheimnisse, Zugangsdaten oder unnötigen personenbezogenen Logs einspeisen.
- Vorgeschlagene Befehle und Konfigurationsänderungen vor Ausführung verstehen.
- Kleine Diffs bevorzugen.
- Nach jeder Änderung das ursprüngliche Fehlerrezept erneut testen.
- Bei sicherheitskritischen Themen Primärdokumentation und Fachwissen heranziehen.
Wann ein Neubau tatsächlich vernünftig sein kann
Die Haltung „erst reparieren“ ist kein Dogma. Es gibt Situationen, in denen die alte Grundlage selbst das Problem ist. Ein Neubau oder eine Migration kann sinnvoll werden, wenn mehrere strukturelle Gründe gleichzeitig vorliegen und sich nicht mit vertretbarem Risiko schrittweise beheben lassen.
- Nicht mehr unterstützte Runtime oder Plattform mit realem Sicherheitsrisiko.
- Architektur verhindert notwendige Anforderungen dauerhaft.
- Abhängigkeiten sind nicht mehr wartbar oder ersetzbar.
- Datenmodell oder Codebasis ist so inkonsistent, dass jede kleine Änderung hohe Regressionen erzeugt.
- Betriebswissen ist verloren und die Plattform nicht mehr reproduzierbar.
- Migration reduziert nachweisbar Komplexität statt sie nur zu verlagern.
Auch dann sollte der Neubau auf der Diagnose des alten Systems beruhen. Wer nicht verstanden hat, warum das alte System scheiterte, kann dieselben Fehler in modernerer Verpackung erneut bauen.
Wann ein CMS-Wechsel gerechtfertigt ist – und wann nicht
| Situation | Bewertung |
|---|---|
| Ein einzelnes Plugin kollidiert nach Update | zuerst Plugin/Version/Kompatibilität untersuchen |
| Theme hat einen CSS-Fehler | lokal reparieren oder Theme gezielt aktualisieren |
| Core ist EOL und erhält keine Sicherheitsupdates | Migration ernsthaft planen |
| Redaktion braucht Funktionen, die nur mit vielen fragilen Workarounds möglich sind | Architekturentscheidung prüfen |
| Seite ist „altmodisch“ | kein technischer Migrationsgrund |
| Datenexport, URLs und Medien lassen sich sauber migrieren und Betrieb wird messbar einfacher | guter Kandidat für Migration |
Ein CMS ist Infrastruktur. Der Wechsel sollte wie ein Infrastrukturprojekt behandelt werden, nicht wie ein CSS-Fix.
Redesign ist keine Fehlerbehebung
Ein neues Layout kann sinnvoll sein, wenn Gestaltung, Zugänglichkeit oder Informationsarchitektur tatsächlich verbessert werden sollen. Es ist aber eine andere Aufgabe als die Reparatur eines 500-Fehlers, einer falschen Weiterleitung oder eines kaputten Formulars.
Wer beides koppelt, verliert Vergleichbarkeit: Funktioniert die Seite wieder wegen der Reparatur oder weil eine komplett andere Struktur entstanden ist? Für langlebige Seiten ist eine Trennung sinnvoll: erst Stabilität herstellen, dann Gestaltung bewusst verändern.
Refactoring: Ordnung schaffen, ohne alles gleichzeitig zu ersetzen
Zwischen Patch und Neubau liegt ein großer Raum. Wiederholte Regeln können zusammengeführt, Funktionen entkoppelt, Templates vereinheitlicht, Abhängigkeiten entfernt und Tests ergänzt werden – schrittweise, mit messbaren Zwischenständen.
Gutes Refactoring verkleinert den zukünftigen Suchraum. Es macht Zuständigkeiten klarer und Nebenwirkungen sichtbarer. Gerade langjährige Webseiten profitieren davon mehr als von periodischen Komplettabrissen.
Eine einfache Entscheidungsmatrix
| Befund | Reparieren | Refaktorieren | Ersetzen |
|---|---|---|---|
| Ursache lokal und verstanden | ja | optional | nein |
| Wiederkehrende Fehler aus derselben Struktur | kurzfristig | ja | nur bei zusätzlichem Grund |
| Plattform sicher und unterstützt | ja | ja | nicht allein nötig |
| Plattform EOL / Sicherheitsrisiko | nur Notmaßnahme | begrenzt | planen |
| Anforderungen grundsätzlich nicht erfüllbar | nein | eventuell | ja |
| Nur Optik wirkt alt | wenn echter Bug | wenn Struktur hilft | kein Grund allein |
Die Matrix ersetzt keine technische Bewertung. Sie verhindert aber, dass „neu“ automatisch als Synonym für „besser“ behandelt wird.
Werkstattablauf: 15 Schritte von der Meldung bis zur sauberen Reparatur
- Fehlerbeschreibung in beobachtbare Begriffe übersetzen.
- Reproduktion mit klaren Bedingungen herstellen.
- Ausgangszustand sichern.
- Betroffenen Umfang bestimmen.
- Letzten bekannten guten Zustand ermitteln.
- Änderungen seit diesem Stand sammeln.
- Technische Schicht eingrenzen: Browser, HTML/CSS/JS, HTTP, Server, Daten, extern.
- Logs und DevTools passend zur Schicht prüfen.
- Eine konkrete Hypothese formulieren.
- Mit der kleinsten reversiblen Änderung testen.
- Originales Fehlerrezept erneut ausführen.
- Nebenwirkungen auf benachbarte Funktionen testen.
- Änderung dokumentieren.
- Produktiv ausrollen und beobachten.
- Erst danach entscheiden, ob strukturelles Refactoring nötig ist.
Der Ablauf darf in einer echten Störung abgekürzt werden. Wichtig ist nicht die Form, sondern dass Beobachtung, Hypothese, Test und Ergebnis nicht durcheinandergeraten.
Fallbeispiel: Mobile Navigation überdeckt die Überschrift
Symptom: Bei einer bestimmten Breite liegt die zweite Navigationszeile über dem Beginn des Inhalts. Die schlechte Reaktion wäre, den Header komplett neu zu bauen. Die bessere Reihenfolge: exakte Breite feststellen, berechnete Höhe prüfen, Sticky-Verhalten ansehen, Media Query identifizieren, lange Labels testen und den kleinsten Wert finden, der die Überlappung verursacht.
> reproduce: 768px
> inspect: nav wraps to second row
> observe: scroll-padding assumes old single-row height
> test: adjust mobile scroll-padding / nav spacing
> fix: local, reversible, no redesign required
Das Ergebnis ist nicht nur ein repariertes Layout, sondern eine Erklärung, warum es an genau dieser Breite fehlschlug.
Fallbeispiel: Nach kleiner Änderung liefert die ganze Site 500
Ein 500 nach einer Konfigurationsänderung ist ein klassischer Fall für Rückkehr zum letzten guten Stand. Zuerst Änderung rückgängig machen oder Konfigurationsdatei aus Backup wiederherstellen. Wenn die Site wieder erreichbar ist, den Diff untersuchen. Webserver-Error-Log und Syntaxprüfung liefern meist mehr als ein Neuaufsetzen des Webspaces.
Erst wenn sich zeigt, dass die Plattform selbst instabil oder nicht mehr supportbar ist, wird daraus ein Migrationsprojekt. Ein einzelner Syntaxfehler in einer Rewrite-Regel ist dafür kein ausreichender Beleg.
Fallbeispiel: Formular funktioniert nur manchmal
Intermittierende Fehler verlangen Korrelation. Browserzeitpunkt, Request, Response und Serverlog müssen zusammengebracht werden. Tritt das Problem nur nach Session-Ablauf auf? Nur bei bestimmten Zeichen? Nur bei großen Anhängen? Nur über IPv6? Nur bei einem externen Maildienst?
Eine komplette Formular-Neuprogrammierung kann denselben Randfall wieder enthalten. Die Diagnose eines konkreten fehlgeschlagenen Requests ist daher wertvoller als ein abstrakter „Neustart“.
Fallbeispiel: Nach Update ist das System „irgendwie anders“
Updates verändern oft mehrere Ebenen gleichzeitig: API-Verhalten, Defaultwerte, CSS, Runtime oder Abhängigkeiten. Deshalb sollten Release Notes, Diff und reproduzierbare Tests zusammen betrachtet werden. Wenn möglich, wird das Update zunächst in einer Kopie oder Stagingumgebung geprüft.
Ist eine Regression klar an eine Version gebunden, kann ein temporärer Rollback sinnvoller sein als hektische Workarounds. Danach lässt sich gezielt entscheiden, ob Anpassung, Bugfix des Herstellers oder Versionssprung der bessere Weg ist.
Typische Denkfehler in der Fehlersuche
- „Es muss der Server sein.“ – ohne Netzwerkmessung oder Logbeleg.
- „Im anderen Browser geht es, also ist Browser A kaputt.“ – ohne Minimalfall.
- „Nach Cache löschen ging es, also war der Cache schuld.“ – ohne Cacheebene zu bestimmen.
- „Das CMS ist alt, deshalb kommt der Fehler daher.“ – Alter ist keine Ursachenanalyse.
- „Neu installieren ist schneller.“ – kann Diagnosebeweise und individuelle Konfiguration zerstören.
- „Die KI sagt, wir sollen Framework X einsetzen.“ – Werkzeugwahl ersetzt keinen Befund.
- „Jetzt läuft es, also fertig.“ – ohne ursprünglichen Test und Nebenwirkungsprüfung.
Alle diese Sätze können am Ende wahr sein. Problematisch ist nur, wenn sie am Anfang als Gewissheit behandelt werden.
Werkzeugkasten für ruhige Fehlersuche
| Bereich | Werkzeug/Information | Wofür |
|---|---|---|
| Browser | DevTools, Console, Network, Inspector | DOM, CSS, JS, Requests, Cache |
| HTTP | curl / Headerprüfung | Status, Redirects, Header, TLS-Indizien |
| Versionen | Git / Diff / bisect | Regressionen und Änderungen |
| Server | Access-/Error-Logs, Syntaxcheck | Requests, 4xx/5xx, Konfiguration |
| DNS/TLS | dig/nslookup, Zertifikatsprüfung | Namensauflösung, Hosts, Zertifikate |
| Daten | reproduzierbarer Testdatensatz | datenabhängige Fehler |
| Sicherung | Snapshot/Backup/Rollback | reversibles Arbeiten |
| Dokumentation | kleines Änderungslog | Zeitachse und spätere Wartung |
Werkzeuge sind dabei nicht das Entscheidende. Entscheidend ist die Reihenfolge: Frage → Messung → Hypothese → kleiner Test → Ergebnis.
Technische Primär- und Referenzquellen
Die Seite ist eine praktische Haltungs- und Werkstattseite. Einzelne technische Methoden lassen sich mit Primär- und Herstellerdokumentationen abgleichen:
- Chrome DevTools – offizielle Dokumentation: Browserwerkzeuge für Inspektion und Diagnose.
- Git – git bisect: binäre Suche nach der Änderung, die eine Regression eingeführt hat.
- RFC 9110 – HTTP Semantics: HTTP-Ressourcen, Requests, Responses und Statussemantik.
- OWASP Logging Cheat Sheet: Anforderungen und Nutzen von Anwendungslogging, insbesondere für Sicherheitsereignisse.
- Nu Html Checker: strukturbezogene HTML-Prüfung als ergänzendes Diagnosewerkzeug.
Die hier vertretene Grundhaltung – kleine reversible Änderungen, Ursachenverständnis und bewusste Trennung von Reparatur, Refactoring und Migration – ist eine redaktionelle Zusammenführung praktischer Wartungsprinzipien und keine universelle Vorschrift für jede Systemarchitektur.
Verwandte Seiten im SSLXY-Archiv
Die Fehlersuche berührt mehrere bereits dokumentierte Themen. Besonders passend sind:
- Aus der Webmaster-Werkstatt – die illustrierte, etwas weniger nüchterne Schwesterseite.
- Webmaster und langfristige Webpflege.
- Wenn Webseiten alt werden – URLs, Redirects, Link-Rot und langlebige Strukturen.
- Reparaturhaltung – Erhalt, Eingriffstiefe und technische Vernunft.
- Datensicherung und Backups.
- Server-Härtung.
- Digitale Standards und Kompatibilität.
- Technische Haltung und Wartbarkeit.
Die beste Reparatur macht das System verständlicher
Gute Fehlersuche endet nicht nur mit „funktioniert wieder“. Im Idealfall ist danach klarer, welche Schicht zuständig war, warum der Fehler entstehen konnte, wie er künftig erkannt wird und ob eine kleine strukturelle Verbesserung Wiederholungen verhindert.
Manchmal führt diese Arbeit tatsächlich zu dem Schluss, dass ein System ersetzt werden sollte. Dann ist der Neubau keine Flucht vor einem unbekannten Problem, sondern eine begründete technische Entscheidung. Ebenso oft zeigt sich aber, dass eine einzelne Regel, ein falsch gesetzter Header, eine inkompatible Erweiterung oder eine kleine Regression für den ganzen Ärger verantwortlich war.
Erst verstehen, dann verändern. Nicht aus Nostalgie, sondern weil Systeme langfristig nur dann beherrschbar bleiben, wenn Reparaturen Wissen erzeugen statt es durch immer neue Schichten zu ersetzen.
Rechtlicher und technischer Hinweis
sslxy.de ist ein privates, nicht-kommerzielles Technik- und Webarchiv. Die hier beschriebenen Verfahren sind technische Dokumentation und kein öffentliches Support-, Beratungs-, Entwicklungs- oder Administrationsangebot.
Konkrete Systeme unterscheiden sich erheblich. Änderungen an produktiven Servern, Datenbanken, DNS, TLS, Sicherheitsmechanismen, CMS oder Anwendungen müssen an die reale Umgebung angepasst, gesichert und getestet werden. Bei Sicherheitsvorfällen oder geschäftskritischen Systemen kann professionelle Incident-Response wichtiger sein als eine allgemeine Werkstattmethode.
Allgemeine Angaben stehen auf der Startseite, rechtliche Angaben im Impressum und Informationen zur Datenverarbeitung in der Datenschutzerklärung.